A raiva de um ator não tem cor: tentei ler emoções pela cor do rosto em Python
Construí em Python um sistema que tenta ler emoções pela cor do rosto em vídeo comum. A câmera quase me enganou, a raiva encenada não ficou vermelha e o melhor resultado veio de onde eu menos esperava.

A raiva de um ator não tem cor. Eu descobri isso depois de passar dias construindo um sistema em Python para ler emoções pela cor do rosto em vídeo comum, de webcam ou de celular, e de rodar esse sistema em centenas de clipes de atores profissionais encenando raiva, medo, alegria e nojo. A alegria apareceu direitinho, com as bochechas mais vermelhas como a literatura prevê, mas a raiva encenada saiu, em média, um pouquinho menos vermelha que o rosto neutro. Esse foi só o primeiro de vários resultados que me obrigaram a separar o que o artigo científico prometia do que um vídeo comum consegue entregar, e é essa jornada que eu quero contar aqui.
O projeto se chama red_face, é open source e está no GitHub. Neste texto eu vou falar menos de como usar e mais do caminho: o que funcionou, o que quebrou, e o que os números realmente disseram.
Neste artigo:
- O artigo que começou tudo
- Como o pipeline funciona
- O verdadeiro inimigo é a câmera
- Medindo o pulso pela cor da pele
- Quando o erro era meu: sorriso não é vergonha
- Testando com gente de verdade
- Cinco regiões contra uma malha de 133 triângulos
- O que eu não faria com isso
- Considerações Finais
O artigo que começou tudo
Em 2018, Benitez-Quiroz, Srinivasan e Martinez publicaram na PNAS um artigo chamado "Facial color is an efficient mechanism to visually transmit emotion". A ideia é elegante: quando sentimos alguma coisa, o fluxo de sangue no rosto muda de forma diferente em cada região, e isso altera a cor da pele de um jeito sutil mas sistemático. Eles dividiram o rosto em 126 regiões, mediram a cor em dois canais oponentes (vermelho contra verde e amarelo contra azul) e mostraram que só com essa informação um classificador linear acertava 50% entre 18 emoções, quando o acaso seria 5,5%, e 93% na valência, ou seja, se a emoção era positiva ou negativa.
O que mais me chamou atenção foi o experimento com pessoas: eles "pintaram" a cor de uma emoção em rostos completamente neutros, sem nenhum músculo se mexendo, e as pessoas reconheceram a emoção acima do acaso. A cor sozinha carrega informação.
Só que tem uma letra miúda que faz toda a diferença. O artigo usou fotos paradas e posadas, e ele supõe que a causa é o sangue, mas não mediu sangue em momento nenhum. Então a pergunta que eu quis responder era bem prática: dá para fazer isso em vídeo comum, do jeito que a gente grava no dia a dia, e o sinal que aparece é mesmo de sangue?
Como o pipeline funciona
A estrutura ficou assim, de ponta a ponta:
- Detecta o rosto em cada quadro com o YuNet, um detector leve do OpenCV que também devolve cinco pontos (olhos, nariz e cantos da boca).
- Recorta regiões de pele: testa, as duas bochechas, nariz e queixo, posicionadas pela distância entre os olhos, que é uma medida que não muda quando a pessoa faz uma expressão.
- Converte para CIELAB, porque nesse espaço de cor o canal a* é exatamente o eixo vermelho e verde, e o b* é o eixo amarelo e azul, os mesmos canais oponentes do artigo.
- Calibra uma linha de base: os primeiros 10 segundos do vídeo são tratados como o estado neutro daquela pessoa, porque comparar a cor do meu rosto com a de outra pessoa não faz sentido nenhum.
- Analisa janelas de 4 segundos, comparando cada uma com a linha de base, e devolve uma emoção provável com probabilidades, valência e confiança, ou então diz que não dá para saber.
Para classificar sem precisar de dados de treino, eu traduzi a literatura de fisiologia em protótipos numéricos: raiva deixa o rosto mais vermelho e acelera o coração, medo deixa pálido e também acelera, vergonha concentra o vermelho nas bochechas, tristeza puxa para o azulado. Para quem tem dados rotulados, o sistema também treina o mesmo tipo de classificador do artigo, uma LDA regularizada.
pip install -e ".[plot]"
redface analyze entrevista.mkv --plot --annotated
O verdadeiro inimigo é a câmera
Esse foi o primeiro choque de realidade. O limiar para uma pessoa perceber que um rosto ficou mais vermelho é de mais ou menos 0,7 unidade de a*, e as mudanças de cor que interessam ficam entre 1 e 3 unidades. O problema é que o erro de calibração de uma câmera comum é dessa mesma ordem de grandeza, e o balanço de branco automático, a exposição automática e a compressão de vídeo mudam a cor da imagem inteira o tempo todo, sem pedir licença.
Eu testei isso de propósito num vídeo sintético: quando a exposição da câmera dá um salto, o rosto "fica" quatro unidades mais vermelho de uma vez, e o sistema, ingenuamente, responderia raiva com muita confiança.
A solução foi usar o fundo da cena como testemunha. Se o rosto mudou de cor mas o fundo também mudou, quem mudou foi a câmera ou a luz, não o sangue, e a janela vira indeterminado. Essa checagem roda em cada quadro, e não na média da janela, porque um salto rápido de luz numa borda da janela escapava da média e passava despercebido.
# por quadro: se o fundo mudou de cor, a mudança no rosto não é confiável
bg_dL = abs(fundo_atual.L - fundo_base.L)
bg_dchroma = np.hypot(fundo_atual.a - fundo_base.a, fundo_atual.b - fundo_base.b)
if bg_dL > 4 or bg_dchroma > 1.5:
    motivos.add("cena_mudou")
Com isso o sistema ganhou uma postura que eu considero a parte mais importante do projeto inteiro: ele prefere não responder a responder errado.
Medindo o pulso pela cor da pele
Já que o artigo não mediu sangue, eu quis medir. A cada batida do coração, a pele fica levemente mais vermelha por uma fração de segundo, e dá para extrair isso do vídeo com uma técnica chamada rPPG (fotopletismografia remota). Eu usei o método POS, de Wang e colegas, que combina os canais de cor de um jeito que cancela boa parte das variações de luz e movimento.
Para validar, rodei na base UBFC-rPPG, que tem vídeos sem compressão e um oxímetro de dedo gravando o pulso real ao mesmo tempo. O erro médio ficou em 5 batidas por minuto, com mediana de 3, e 69% das janelas ficaram a menos de 5 bpm da referência. Não é equipamento médico, mas é um sinal de sangue de verdade, medido por uma webcam.
E aqui veio o segundo choque. Nessa mesma base, os voluntários estão só resolvendo contas de matemática sob pressão, sem nenhuma emoção específica envolvida, e mesmo assim os protótipos responderam nojo 43 vezes e medo 13 vezes. Estresse, esforço mental e pequenas derivas da câmera viram "emoção" com muita facilidade, e esse é o tamanho real do problema de falso positivo nessa área.
Quando o erro era meu: sorriso não é vergonha
Quando comecei a testar com rostos reais, apareceu um erro que me incomodou bastante: pessoas sorrindo eram classificadas como vergonha. E fazia sentido do ponto de vista da cor, porque sorrir deixa as bochechas mais vermelhas, e o protótipo de vergonha é justamente "bochechas mais vermelhas que a testa".
A tentação era deixar o erro documentado e seguir em frente, mas a pergunta certa era outra: que informação está faltando? A resposta estava nos próprios pontos do detector. Eu passei a medir a largura da boca dividida pela distância entre os olhos, comparada com a linha de base, e esse índice de sorriso entrou como mais uma dimensão dos protótipos.
sorriso = largura_da_boca / distancia_entre_olhos # relativo à linha de base
No meio do caminho apareceu outro problema parecido: quando a pessoa sorria ou falava, a região do queixo escorregava para cima da boca, e o lábio vermelho virava "rubor". A correção foi excluir uma elipse ao redor da boca de todas as medidas de cor. Parece óbvio depois, mas só apareceu quando eu olhei os quadros um por um.

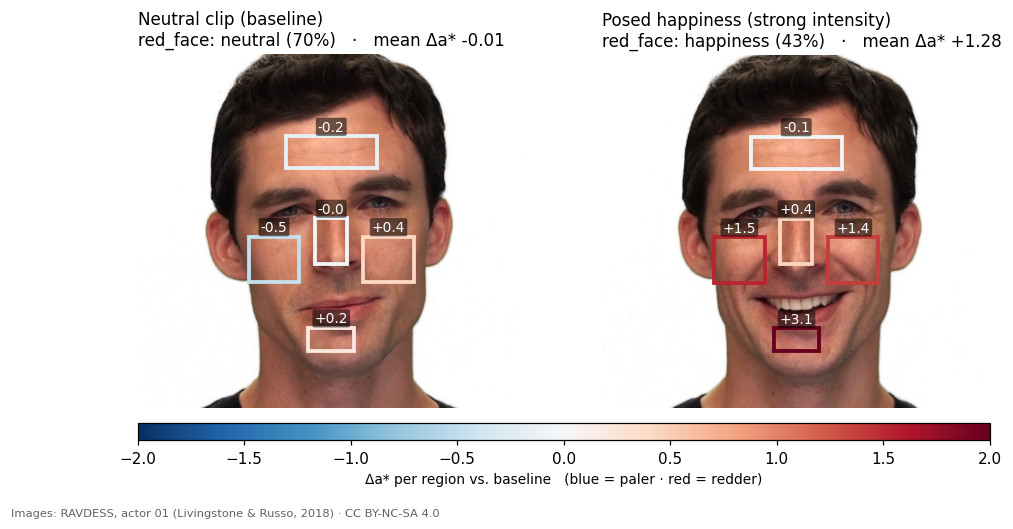
À esquerda, a linha de base neutra; à direita, alegria posada, com as bochechas cerca de 1,5 unidade de a* mais vermelhas. Imagens: RAVDESS (Livingstone & Russo, 2018), licença CC BY-NC-SA 4.0.
Testando com gente de verdade
Bases com emoção induzida de verdade, aquelas em que a pessoa assiste a um trecho de filme e sente alguma coisa, exigem contrato ou cadastro, então eu usei a RAVDESS, uma base aberta com atores encenando oito emoções em duas intensidades. É material posado, igual às fotos do artigo da PNAS, e isso importa muito para interpretar o que vem a seguir.
A média de mudança de cor por emoção, comparando com os clipes neutros de cada ator, contou uma história clara. A alegria ficou +0,65 unidade mais vermelha, chegando a +0,90 na intensidade forte, acima do limiar de percepção. A raiva ficou −0,19, ou seja, nada de rosto vermelho. Faz sentido quando a gente pensa no que é um ator: ele reproduz a expressão da raiva, mas não está com a pressão subindo nem com o sangue indo para o rosto.
Com isso, os protótipos da literatura acertaram 21% entre sete classes, praticamente empatados com chutar sempre "neutro", que dá 20%. Ou seja, em material posado, a fisiologia descrita na literatura simplesmente não aparece, com exceção da alegria.
Também testei numa entrevista pública da Royal Society, licenciada em CC BY 3.0. Nos trechos contínuos, a cor da entrevistada ficou parada dentro da faixa abaixo do limiar de percepção e o sistema respondeu "neutro" em todas as janelas que aceitou analisar, sem inventar emoção. No trecho com cortes de câmera, ele não respondeu nada depois do primeiro corte, o que é o comportamento correto, porque a linha de base deixa de valer quando muda o enquadramento ou a pessoa.

Entrevista calma: a variação de vermelho nunca sai da faixa cinza, abaixo do que uma pessoa conseguiria perceber.
Cinco regiões contra uma malha de 133 triângulos
Até aqui o sistema usava cinco retângulos, enquanto o artigo usava 126 regiões. Então eu repliquei a ideia: usei o MediaPipe para pegar 478 pontos do rosto, triangulei, tirei olhos, sobrancelhas e boca, e cheguei a uma malha de 133 triângulos de pele.

A malha de 133 triângulos de pele, sem olhos, sobrancelhas e boca, como no artigo da PNAS. Imagem: RAVDESS, CC BY-NC-SA 4.0.
O resultado, sempre deixando um ator inteiro de fora do treino:
| Abordagem | Acerto (7 emoções) |
|---|---|
| Protótipos da literatura | 21% |
| LDA com 5 regiões | 33% |
| LDA com a malha de 133 triângulos | ~50% |
| Malha com rótulos embaralhados (controle) | 14% |
A malha praticamente dobrou a distância para o acaso, e o controle com rótulos embaralhados mostrou que não era sorte. Eu poderia ter parado aí e comemorado, mas resolvi perguntar de onde vinha esse ganho, e a resposta mudou a leitura do projeto inteiro.
Quando usei só os triângulos colados nos olhos, nas sobrancelhas e na boca, o acerto ficou em 49%. Quando usei só os 18 triângulos longe dessas áreas, caiu para 38%. E o canal amarelo e azul informava mais que o vermelho e verde, 51% contra 39%, o que não combina com uma história de fluxo de sangue. A leitura mais provável é que a malha está captando expressão através da cor: a sombra de uma sobrancelha franzida, uma ruga que aparece, a pele que estica no sorriso. É exatamente a confusão que o artigo da PNAS, com fotos posadas, não tinha como descartar.

Um ator que o modelo nunca viu: alegria, surpresa e nojo saem quase sempre certos, medo, tristeza e raiva quase nunca. Faixas laranjas são janelas que o sistema se recusou a responder.
Mesmo assim eu levei a malha para o produto, como um modo opcional (--regions malha), porque ela é útil para quem tem dados rotulados e quer treinar o próprio modelo, desde que saiba o que ela está medindo.
O que eu não faria com isso
Detecção de mentira, nem pensar. Nenhum sinal facial, seja cor, temperatura ou microexpressão, foi validado para isso, e o próprio artigo da PNAS fala de emoção, não de mentira. Pessoas acertam mentiras em torno de 54% das vezes, quase uma moeda.
Também tem a questão legal. Vídeo de rosto é dado biométrico, e no Brasil isso é dado pessoal sensível pela LGPD, o que exige consentimento específico e finalidade clara. Na União Europeia, o AI Act proíbe inferir emoções no ambiente de trabalho e em escolas desde fevereiro de 2025. Então nada de usar algo assim em entrevista de emprego, sala de aula ou monitoramento de funcionário. É uma ferramenta de pesquisa e curiosidade, e o README do projeto deixa isso bem explícito logo no topo.
Considerações Finais
Eu comecei esse projeto querendo um detector de emoção pela cor do rosto e terminei com algo que eu acho mais honesto: um medidor de pulso razoável, um sistema que percebe quando a câmera está mentindo para ele, e uma evidência pequena, mas clara, de que boa parte do que parece "cor da emoção" em material posado é, na verdade, expressão vista pela cor.
As lições que eu levo são mais gerais que o tema. Comparar uma pessoa com ela mesma é muito mais robusto do que comparar com uma média. Um sistema que diz "não sei" com um motivo é mais útil do que um que sempre responde. E quando um número fica bom demais, vale perguntar de onde ele vem antes de comemorar, porque foi justamente essa pergunta que transformou um "50% de acerto" num resultado bem mais interessante.
O próximo passo de verdade seria testar com emoção induzida, vídeo sem compressão e pulso de referência, que é onde a hipótese do sangue pode finalmente ser confirmada ou descartada. O código está aberto para quem quiser tentar.